PyMC を wasm にコンパイルしてブラウザで動かした
少し前に、Stan のサブセットをパースからサンプリングまでブラウザの中で完結させる stanwasm について書きました。
その中の、自動微分テープを WebAssembly のモジュールにコンパイルして、同じメモリの上で nuts-rs にサンプリングさせる部分は、PyMC でも使えるのではとふと思いました。
そこでこの部分を tapewasm というライブラリとして切り出し、2 つ目のフロントエンドとして PyMC をつなぎました。
以下は、実際に Web 上の PyMC でサンプリングしてみたデモです。
wasm を通して、ブラウザの上でサンプリングが実行されています。
少し大きなモデルも動きます。
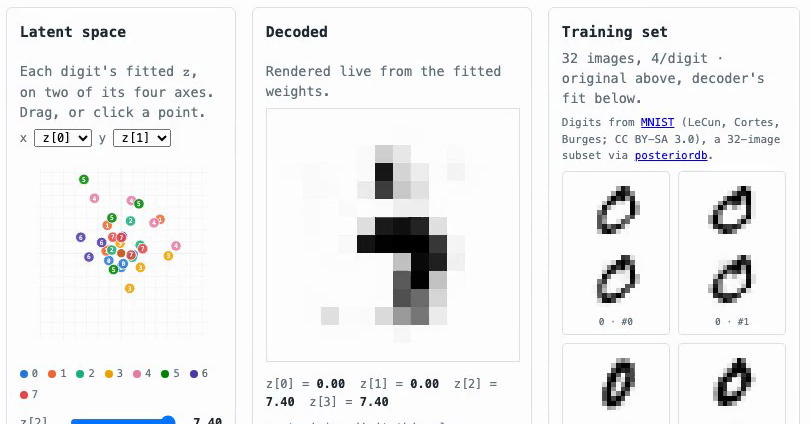
次のデモは、MNIST の手書き数字 32 枚を、4 次元の潜在変数から画素を出す小さなニューラルネットのデコーダ(パラメータ 4,344 個)で表し、変分推論(平均場 ADVI)でブラウザの中で学習させているところです。
モデルは PyMC で 10 行ほどで、事前に pymcwasm-build で wasm のモジュールにしてあるので、ページでは Python を読み込まずに学習が走ります。
 habakan/pymcwasmPyMC のモデルをブラウザでサンプリングする。対数密度を WebAssembly にコンパイルし、nuts-rs で引くgithub.comhabakan/tapewasm対数密度を WebAssembly のモジュールにコンパイルし、ブラウザでサンプリングするgithub.com
今はどちらも、PyMC とは関係のない個人のプロジェクトとして開発しています。
PyMC のツールチェーン
PyMC のツールチェーンを見ると、自動微分などは pymc-devs の中で管理されている PyTensor というライブラリが担っています。
PyTensor はモデルの計算をグラフとして持ち、C や Numba、JAX のコードに変換してコンパイルすることで速く計算します。GPU で計算させることもできます。
このグラフをどのコードに変換するかを決める部品を、PyTensor では linker と呼びます。
PyMC 自体はそのまま wasm 化ができる
PyMC は、実は現状でもブラウザで動かすことができます。
PyMC Labs の nuts-rs-wasm のように、Numba を含む専用の Xeus / Emscripten 環境を用意して、ブラウザで PyMC をサンプリングする取り組みもすでにあります。
この記事で扱うのは、JupyterLite や marimo がページの中で Python を動かすのに使っている、標準の Pyodide のほうです。
PyMC は Pyodide の上に、そのままインストールできます。
ただ、wasm 側で失われるのはコンパイラです。
PyMC は対数密度を PyTensor に渡し、PyTensor は普段そのグラフを C のコードに変換してコンパイルします。
Pyodide には C コンパイラがありません。前の記事の「Stan を wasm 化するときの留意点」で書いたのと同じで、ブラウザにはコンパイラを持ち込めないという問題です。
そのため PyTensor は Python の linker に切り替え、グラフをノードごとに Python で計算します。
動きはしますが、ネイティブほどパフォーマンスが出ないのが難点です。
3,020 件の観測があるロジスティック回帰では、JupyterLite のタブの中で PyMC の NUTS を回すと、有効サンプル数(ESS)が 1 秒あたり 1 程度でした。
tapewasm を PyMC のブラウザ環境で活用する
そこで今回、wasm 環境を想定した自動微分の tapewasm を活用して、PyMC をより速く wasm で動かせないか試みました。
使い方は 2 つあります。
1 つ目は、モデルのコードを何も変えない方法です。import pymcwasm.linker をすると "WASM" という PyTensor の linker が登録され、どの PyTensor の関数もこれでコンパイルできるようになります。
import pymcwasm.linker
await pymcwasm.linker.load(tapewasm_url)   # Pyodide ではページごとに 1 回

with model:
    idata = pm.sample(compile_kwargs={"mode": "WASM"})
サンプラーは PyMC 自身の NUTS のままで、Python で動きます。
変わるのは、そのサンプラーが求める対数密度と勾配の計算が、グラフをたどる代わりに WebAssembly のモジュールの呼び出しになることです。
2 つ目は、もう一歩踏み込む方法です。
密度の計算が速くなると、残りの時間の大半は PyMC のサンプラーが Python で 1 ステップずつ進む部分になります。pymcwasm.sample は同じ密度を一度コンパイルし、サンプラーごとモジュールに渡すので、1 ステップごとに Python が動くことはありません。
fit = await pymcwasm.sample(model, draws=500, warmup=500, chains=2)
idata = fit.to_inference_data()
notebook の eight schools のモデルで、2 chains × 1,000 iterations を回した結果です。
| ページの中での時間 | |
|---|---|
| PyMC の NUTS、PyTensor の Python の linker | 5.8 秒 |
PyMC の NUTS、mode="WASM" |
1.2 秒 |
pymcwasm.sample |
0.02 秒(別にコンパイル 0.21 秒) |
どう動いているか
PyMC のモデルは、PyTensor のグラフとして表されています。
pymcwasm はこのグラフを、足し算や掛け算のようなスカラーの演算を並べた「テープ」に書き出します。データは定数として埋め込みます。
tapewasm はこのテープを、対数密度とその勾配を 1 回の呼び出しでまとめて返す wasm のモジュールにします。
サンプラーの nuts-rs は同じメモリの上でこのモジュールを呼ぶので、1 回の勾配の計算が、データのコピーなしの関数呼び出し 1 回で済みます。
モジュールは小さなモデルなら 5〜35 KB で、事前にビルドしておけば、Python を読み込まないページにも載せられます(MNIST のデモがこの形です)。
1 つ制約があります。テープには if のような分岐がないので、sigma > 0 のような比較は、書き出した時点の結果で固定されます。
そこで、呼び出すたびにその比較の結果が変わっていないかを確かめ、変わっていたら書き出し直すようにしています。
正しさは posteriordb で確かめています。PyMC の実装がある 83 件のうち 79 件で、対数密度と勾配が PyMC と一致しました(残りの 4 件は、まだ対応していない演算を使っています)。このチェックは CI で回しています。
パフォーマンスの測定
規模による違いを見るため、posteriordb からパラメータ数 2〜3,075 の 9 件を選び、5 つの方式で回しました。Chromium の Pyodide の Worker で 3 通り、比較として CPython で PyMC の NUTS と nutpie です。
どれも 2 chains × (500 warmup + 500 draws) で、サンプリング時間 1 秒あたりの最小の bulk ESS で比べています。計測は Apple M3 です。
| モデル | パラメータ数 | Pyodide、Python の linker | Pyodide、mode="WASM" |
Pyodide、pymcwasm.sample |
CPython、PyMC の NUTS | CPython、nutpie |
|---|---|---|---|---|---|---|
| eight schools | 10 | 76 | 719 | 3,944 | 2,213 | 21,333 |
| arK | 7 | 35 | 259 | 1,178 | 685 | 4,545 |
| radon(切片が変動) | 89 | 11 | 114 | 345 | 326 | 2,015 |
| wells(ロジスティック) | 2 | 1.0 | 98 | 148 | 285 | 402 |
| radon(観測 12,573 件) | 391 | 0.3 | 4.7 | 5.5 | 16 | 78 |
ページの中では、mode="WASM" は Python の linker の 10〜100 倍でした。pymcwasm.sample は、パラメータ 100 個程度までなら CPython の PyMC の NUTS についていけていて、これは予想していませんでした。
nutpie にはついていけず、同じ範囲で 3〜10 倍遅く、データが大きいほど差が開きます。観測数の多いモデルでは 3〜15 倍です。
モジュールがスカラーの演算を並べたテープなのに対し、nutpie は numba でベクトル化されたループを回していて、大きなデータではその差がそのまま出ます。
表の全体と計測のコードは bench/ にあります。
まだできないこと
Scan を lowering していないので、状態空間モデルは使えません。
範囲チェックではない本物の分岐がパラメータに依存する場合は、コンパイルではなくガードで扱うので、動きはしますがたどり直しが起きます。Maximum、BetaInc、離散パラメータにはまだ対応しておらず、事後予測分布もモジュールの中では計算できません。
そして、上で見たとおり、データが大きいとモジュールの大きさと速さの面で不利になります。
おわりに
PyMC をブラウザで速く動かすために、PyTensor のグラフを自動微分テープに書き出し、wasm のモジュールにして呼ぶ形にしました。
標準の Pyodide のままでも、mode="WASM" を付けるだけで PyMC の NUTS は速くなり、サンプラーごとモジュールに渡せばパラメータ 100 個程度まではネイティブの PyMC に並びます。
次に取り組みたいのは、大きなデータでの速さです。テープをスカラーの演算の列ではなく、ベクトルの演算のまま扱えるようにすれば、nutpie との差は縮められるはずです。
JupyterLite で教えている方や、サーバなしでページに載せたいモデルがある方がいたら、役に立つかどうか、どこで壊れるかを教えてもらえると嬉しいです。